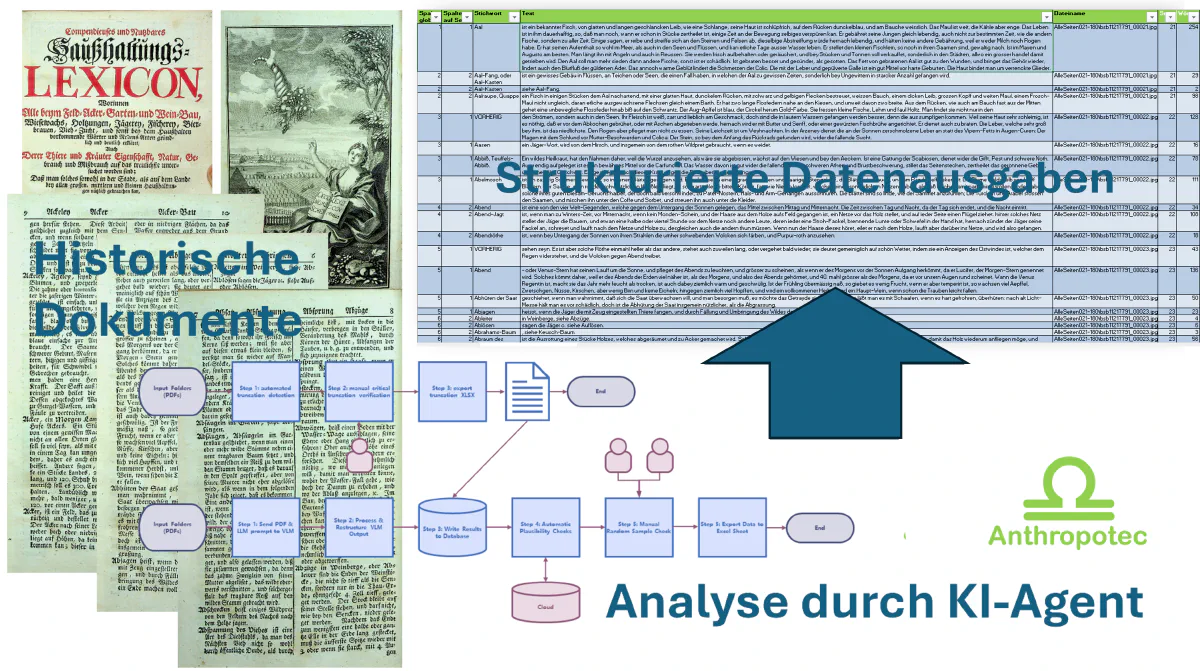
Im Projekt werden ausgewählte Schriften des 18. Jahrhunderts mit Hilfe moderner Technologien untersucht. Mithilfe von Large Language Models (LLM) und Vision Language Models (VLM) werden sowohl die historischen Schriften als auch die Sprache analysiert.
Ein zentrales Ziel ist es, die Buchinhalte in ein strukturiertes Ausgabeformat – beispielsweise eine Datenbank – zu übertragen, um sie der weiteren wissenschaftlichen Analyse zugänglich zu machen.
Fragestellung
Wie lassen sich umfangreiche Druckwerke des 18. Jahrhunderts zuverlässig und nachvollziehbar in strukturierte Daten überführen – so, dass Historikerinnen und Historiker den Ergebnissen vertrauen und sie selbst überprüfen können?
Das Beispiel: ein Haushaltungs-Lexikon
Als Erprobungsobjekt dient das „Compendieuses und Nutzbares Haußhaltungs-Lexicon“ aus dem 18. Jahrhundert. Es beschreibt in alphabetischen Stichworten, was im damaligen Haushalt, in Feld-, Acker-, Garten- und Weinbau, Viehzucht, Jagd und Fischerei wissenswert war – vom Aal bis zum Abraum. Damit ist es ein Fenster in den Alltag, die Sprache und das Wissen jener Zeit.
Herkunft der Methode
Die Herangehensweise wurde zunächst für die Erschließung historischer Musikdrucke entwickelt. Für das Haushaltungs-Lexikon haben wir sie übertragen – von Notendrucken mit Titelblatt, Widmung und Register hin zu einem umfangreichen Nachschlagewerk.
Vorgehen in zwei Ebenen
Dokumentebene. Zuerst wird das ganze Werk betrachtet: Welche Seitentypen gibt es – Einband, Titelblatt, Vorrede, Lexikonseiten, Register? Daraus entstehen ein Dokumentensteckbrief und ein semantisches Gedächtnis, das bei jeder einzelnen Seite mitgeführt wird. So „weiß“ das System, in welchem Werk und an welcher Stelle es gerade liest.
Seitenebene. Dann wird jede Seite als Bild an ein Vision Language Model übergeben. Es erfasst Schrift und Seitenaufbau zugleich: Es erkennt Stichworte, Spalten und Textabschnitte und überträgt den Fraktursatz in heutige Zeichen. Gesteuert wird es durch strukturierte Anweisungen, die zum Seitentyp passen, und durch passende Beispiele, die aus einer Vektordatenbank abgerufen werden (Retrieval Augmented Generation).
Die Ergebnisse werden in eine Datenbank geschrieben – je Eintrag mit Stichwort, Text, Seite, Spalte, Wortzahl und Herkunftsdatei – und lassen sich als Tabelle ausgeben.
Prüfen statt glauben
- VLM liest Seite
- Datenbank
- Plausibilitätsprüfung
- Prüfmodell · GND-Abgleich
- kritische Nachprüfung
- Stichprobe von Hand
- Tabelle
Entscheidend ist, was danach geschieht. Automatische Plausibilitätsprüfungen erkennen etwa Einträge, die über Spalten- oder Seitengrenzen hinweg fortgesetzt oder abgeschnitten wurden; diese Stellen werden gezielt kritisch nachgeprüft. Ein zweites Modell prüft die Ergebnisse mit verändertem Kontext, und erkannte Ortsangaben werden mit der Gemeinsamen Normdatei (GND) abgeglichen. Fachleute kontrollieren zusätzlich Zufallsstichproben von Hand.
Warum das für erklärbare KI steht
Sprachmodelle liefern flüssige, überzeugend wirkende Texte – auch dann, wenn sie sich irren. Wir setzen deshalb nicht auf ein einzelnes Modell, sondern umgeben es mit einer erklärbaren Schale aus Steuerung, Kontext, Normierung, Gedächtnis und Prüfung. Jede Angabe lässt sich bis zur Originalseite zurückverfolgen.
Grundlagen: Das Schalenmodell – wie eine erklärbare Schicht um das KI-Modell entsteht →Stand und Ausblick
Die Verarbeitungskette ist als Prototyp aufgebaut und wird am Haushaltungs-Lexikon erprobt. Als Nächstes sollen weitere Werke aus der Chemnitzer und sächsischen Geschichte erschlossen werden. Das Verfahren lässt sich auf andere Quellen übertragen – etwa Briefe, Akten, Geschäftspapiere oder Konzertprogramme.